
Как создать файл robots.txt для сайта
Файл robots.txt подсказывает поисковым роботам, какие разделы сайта не надо обходить: корзину, результаты внутреннего поиска, служебные страницы. Это обычный текстовый файл на несколько строк, но одна лишняя косая черта способна закрыть от роботов весь сайт.
Ниже — где файл должен лежать, какие директивы он понимает, готовый пример и проверка. Отдельно разбираем главную ошибку: robots.txt не убирает страницы из поиска. Сведения приведены по документации Google и Яндекса.
- Создайте текстовый файл с именем robots.txt в кодировке UTF-8 и положите его в корень сайта: example.ru/robots.txt.
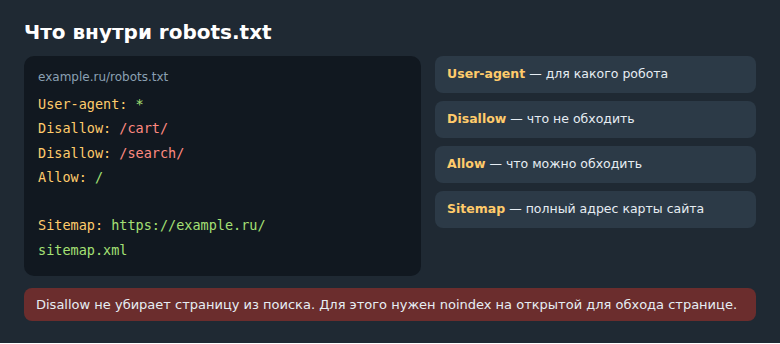
- Основа — строки User-agent, Disallow, Allow и Sitemap.
- Размер не больше 500 КБ: больше поисковики учитывать не станут.
- Страницу из поиска убирает noindex, а не запрет в robots.txt.
- Проверяйте файл в анализаторе Яндекс Вебмастера и отчёте robots.txt в Search Console.
Основные правила файла
- Имя и место. Только robots.txt и только корень хоста. Файл в подпапке работать не будет. Для поддомена и другого порта нужен свой файл.
- Формат. Простой текст. Пишите в «Блокноте» или редакторе кода, а не в Word, и сохраняйте в UTF-8.
- Ответ сервера. Для Яндекса адрес должен отдавать код 200 OK. Если требования не выполнены, сайт считается открытым для индексирования.
- Размер. Яндекс указывает предел 500 КБ, Google учитывает первые 500 КиБ, остальное игнорирует.
- Кириллица. Яндекс запрещает её в файле: домены записывайте в Punycode, а адреса в процентной кодировке.
- Регистр. Названия директив можно писать в любом регистре, а пути чувствительны: /Blog и /blog — разные адреса.
Какие директивы использовать
| Директива | Для чего | Пример |
|---|---|---|
| User-agent | К какому роботу относится группа правил. Звёздочка — ко всем | User-agent: * |
| Disallow | Запрет обхода раздела или страницы | Disallow: /cart/ |
| Allow | Разрешение, в том числе внутри запрещённого раздела | Allow: /cart/help/ |
| Sitemap | Полный адрес карты сайта | Sitemap: https://example.ru/sitemap.xml |
| Clean-param | Только для Яндекса: параметры адреса, которые можно не учитывать | Clean-param: ref /some_dir/get_book.pl |
Символ * заменяет любое количество символов, а $ обозначает конец адреса. Например, Disallow: /*.pdf$ закроет адреса, заканчивающиеся на .pdf. Символ # начинает комментарий. Директиву crawl-delay Google не поддерживает.
Как создать файл: пошагово
- Откройте текстовый редактор и создайте новый файл.
- Выпишите служебные разделы, которые не нужны в поиске: корзина, личный кабинет, внутренний поиск.
- Запишите правила по образцу ниже.
- Сохраните как robots.txt в кодировке UTF-8. Следите, чтобы редактор не добавил второе расширение.
- Загрузите файл в корень сайта через файловый менеджер хостинга или FTP.
- Откройте example.ru/robots.txt в приватном окне браузера: текст должен отображаться.
- Проверьте файл в сервисах поисковиков.
Готовый пример
Базовый вариант для небольшого сайта. Подставьте свои разделы и домен:
User-agent: *
Disallow: /cart/
Disallow: /account/
Disallow: /search/
Allow: /

Sitemap: https://example.ru/sitemap.xml
Если файла нет или он пуст, роботы по умолчанию обходят весь сайт. Поэтому запреты нужны только там, где есть причина. Сайт без служебных разделов может обойтись одной строкой с адресом карты сайта.
Для WordPress подойдёт такой образец: закрыть служебную панель, но оставить файл admin-ajax.php, через который работают функции темы.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.ru/wp-sitemap.xml
Не закрывайте папки с CSS, скриптами и изображениями: роботам нужно видеть страницу так, как её видит посетитель.
Главная ошибка: путать обход и индексацию
Robots.txt управляет только тем, какие адреса роботы посещают. Страница с запретом может остаться в поиске или попасть туда по ссылкам с других сайтов. Яндекс прямо пишет: чтобы удалить страницы из поиска, используйте директиву noindex в HTML-коде или HTTP-заголовке и не закрывайте такие страницы в robots.txt, иначе робот не увидит указание. Google тоже советует для запрета индексации метатег.
Правильный порядок для страницы, которую нужно убрать:
- Откройте её для обхода в robots.txt.
- Поставьте на ней метатег noindex.
- Дождитесь, пока она исчезнет из поиска.
И помните, что robots.txt публичен. Его может прочитать любой, поэтому не перечисляйте там секретные разделы: закрывайте их паролем.
Частые ошибки
- Disallow: / в рабочем файле. Закрывает весь сайт. Часто остаётся после разработки на тестовой версии.
- Закрытая страница с noindex. Робот не увидит тег.
- Несколько групп для одного робота. Каждый робот использует одну наиболее подходящую группу. Если для Яндекса есть отдельная группа, общие правила к нему не относятся: продублируйте нужные запреты.
- Неполный адрес карты сайта. В Sitemap нужен адрес целиком, с https.
- Кириллица в пути. Переведите её в процентную кодировку.
После загрузки проверьте несколько важных адресов сайта в анализаторе: главная и карточки товаров должны быть разрешены, а служебные разделы запрещены.
Частые вопросы
Обязателен ли robots.txt?
Нет. Без него роботы обходят всё, что могут найти. Файл нужен, если есть что исключить или если вы хотите указать карту сайта.
Как быстро поисковики увидят изменения?
Они запрашивают файл сами и хранят копию какое-то время. Срочное обновление Google можно запросить в Search Console.
Нужна ли директива Host?
В актуальной справке Яндекса про robots.txt она не описана. Главное зеркало настраивайте редиректом.
Какой файл на поддомене?
Свой. Файл действует только для своего протокола, хоста и порта.
© kak2.ru
Оставить комментарий